기획특집 다수의 회귀 모델을 동시에 활용한 고속 측정
페이지 정보
작성자 최고관리자 댓글 0건 조회 67회 작성일 26-09-15 15:12본문
다차원 공간에서의 정밀 측정은 탐색 영역의 증가와 함께 막대한 계산 자원과 측정 시간을 요구한다. 본고에서는 복잡한 퍼텐셜 지형(landscape)을 효율적으로 탐색하고 목적 함수를 최적화하기 위한 기계학습(machine learning) 기반 전략을 제안한다. 특히 가우시안 프로세스(Gaussian process)를 활용한 전통적인 베이지안 추론 방식이 갖는 모델 업데이트 연산 복잡도 O(N3)의 한계를 극복하기 위해, 다수의 k-최근접 이웃(k-NN) 회귀 모델을 앙상블 형태로 구성하고 예측 평균과 불확실도(분산)를 O(N) 수준의 계산 복잡도로 동시에 추정하는 방법을 소개한다.
또한 불확실성이 높은 영역에 측정을 집중하는 지능형 능동 샘플링(active sampling) 전략을 적용함으로써 고분해능 이미징과 신속한 측정을 동시에 구현하고, 이를 기반으로 효율적인 목적 함수의 전역 최적화(global optimization) 방법론을 제시한다.
1. 다차원 공간 측정의 한계와 래스터 스캔
현대의 정밀 측정 과학은 고차원 공간에 형성된 복잡한 퍼텐셜 지형(potential landscape)을 해석하고, 최적의 제어 변수를 탐색하는 과제에 직면하고 있다. 예를 들어 양자 컴퓨팅 구현을 위한 다차원 게이트 전압 최적화나 고차원 힐베르트 공간에서의 제어 문제는 방대한 측정 자원과 계산 비용을 요구한다. 이러한 문제를 해결하기 위해 최근에는 기계학습(machine learning), 베이지안 최적화(Bayesian optimization), 진화 연산(evolutionary computation)과 같은 고도화된 인공지능 알고리즘이 지능형 제어층(control layer)의 핵심 요소로 도입되고 있다.
다차원 이미징 및 측정 분야에서 가장 널리 활용되는 주사 방식은 래스터 스캔(raster scan)이다. 래스터 스캔은 빠른 축(fast axis)과 느린 축(slow axis)을 따라 탐침 또는 빔을 이동시키며 2차원 영역을 순차적으로 탐색하는 방식으로, 주사투과전자현미경(STEM)과 원자현미경(AFM) 같은 나노 측정 장비에서 시료 표면의 신호를 획득하는 기본적인 측정 방식으로 활용되고 있다. 특히 각 픽셀 위치에서 2차원 회절 패턴을 동시에 기록하는 4D-STEM과 같은 고차원 이미징 기술에서는 스캔 해상도와 체류 시간(dwell time)의 최적화가 신호 대 잡음비(SN R)와 측정 효율을 결정하는 핵심 요소가 된다.
래스터 스캔은 측정 방식이 직관적이고, 획득 데이터가 균일한 격자(grid) 구조를 가지므로 FFT와 같은 수치해석 기법 적용에 유리하다는 장점이 있다. 그러나 시료 정보가 존재하지 않는 영역까지 동일한 밀도로 측정해야 하므로 불필요한 측정 시간이 증가하며, 장시간 스캔 과정에서는 장비의 열적 표류(thermal drift)에 따른 이미지 왜곡 가능성도 커진다.
이러한 비효율성은 나이퀴스트-섀넌 샘플링 정리(Nyquist-Shannon sampling theorem)의 요구 조건과 결합되면서 더욱 심화된다. 이 정리에 따르면 신호 왜곡(aliasing) 없이 원 신호를 복원하기 위해서는 측정 대상 신호의 최대 공간 주파수 fmax에 대해 최소 2배 이상의 샘플링 주파수 fs가 필요하다(fs > 2fmax). 이는 시료 내 가장 미세한 구조를 분해하기 위해 매우 조밀하고 균일한 빔 스캔을 요구하며, 이러한 요구 조건이 다차원 공간으로 확장될수록 측정 비용이 급격하게 증가하는 차원의 저주(curse of dimensionality) 문제로 이어진다.
2. 불확실성 정량화 : 베이지안 추론과 앙상블 모델
모든 공간 영역을 균일한 밀도로 측정하는 대신, 함수값의 변동성이 크거나 정보량이 높은 영역에 측정을 집중할 수 있다면 측정 효율은 크게 향상될 수 있다. 이를 실현하기 위해서는 측정 과정에서 어느 위치가 불확실성이 높고 추가 탐색 가치가 있는지를 판단하는 방법이 필요하다. 이때 핵심적인 역할을 하는 것이 베이지안 추론(Bayesian inference)이다.
단일 최적값(point estimate)만을 도출하는 전통적인 최적화 방법과 달리, 베이지안 추론은 불확실성을 확률적으로 정량화한다. 즉, 사전 지식(prior)과 관측 데이터(likelihood)를 결합하여 사후 확률 분포(posterior)를 갱신하고, 예측 결과뿐만 아니라 해당 예측에 대한 신뢰 수준을 함께 제공한다. 이러한 특성은 측정 자원을 어디에 우선 배분할 것인지 결정하는 능동 샘플링(active sampling)의 핵심 기반이 된다.
그러나 실제 계산 과학 환경에서 고차원 문제에 대한 엄밀한 베이지안 추론을 수행하는 것은 상당한 계산 비용을 요구한다. 이에 따라 현대 기계학습 분야에서는 다수의 예측 모델을 결합하는 앙상블(ensemble) 기법을 베이지안 추론의 실용적 근사 방법으로 활용하고 있다. 특히 부트스트랩(bootstrap) 기반 앙상블은 충분한 조건에서 베이지안 사후 분포의 불확실성을 근사할 수 있는 방법으로 연구되어 왔다.
대표적 방법인 딥 앙상블(deep ensembles)은 대규모 베이지안 신경망(Bayesian neural network, BNN)을 직접 학습하는 대신, 서로 다른 초기 조건이나 학습 과정으로 훈련된 다수의 신경망을 구성하고 이들의 예측 분산을 이용하여 모델의 인식론적 불확실성(epistemic uncertainty)을 추정한다. 또한 MC 드롭아웃(Monte Carlo dropout)을 이용해 반복적인 예측 편차를 계산하는 방법은 복잡한 사후 분포를 단순화된 분포로 근사하는 변분 추론(variational inference)의 관점에서 해석될 수 있다. 그림 1은 측정 불확실성을 정량화하고 이를 의사결정에 활용하기 위한 주요 방법론을 개념적으로 비교한다.

3. 대리 모델의 혁신: 가우시안 프로세스에서 다중 k-NN으로
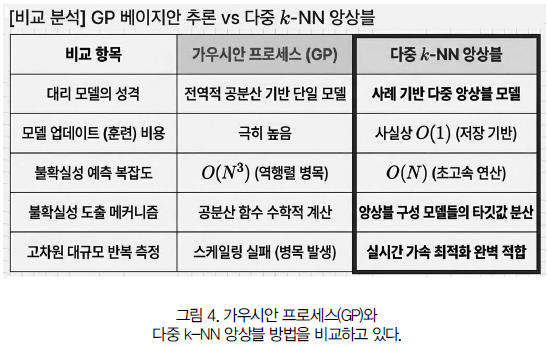
현재 베이지안 최적화에서 대리 모델(surrogate model)로 가장 널리 활용되는 방법 중의 하나는 가우시안 프로세스(Gaussian process, GP)이다. GP는 입력 위치 x에 대한 예측 평균 μ(x)와 불확실성 σ(x)를 함께 제공하므로, 이를 기반으로 상한 신뢰 구간(upper confidence bound, UCB)과 같은 획득 함수(acquisition function)를 구성할 수 있다. UCB(x) = µ(x) + κσ(x). 여기서 k는 탐색(exploration)과 활용(exploitation)의 균형을 조절하는 계수이다. 그러나 GP는 새로운 관측 데이터를 추가할 때 전체 데이터 간 공분산 행렬의 역산이 필요하며, 데이터 개수 N 증가에 따라 모델 업데이트 과정에서 O(N3)의 계산 복잡도를 갖는다. 따라서 반복적인 측정과 최적화가 필요한 고차원 역설계(inverse design) 및 능동 샘플링 환경에서는 이러한 계산 비용이 심각한 병목 요인으로 작용한다.
본 연구에서는 이러한 한계를 극복하기 위한 대안으로 다수의 k-최근접 이웃(k-nearest neighbors, k-NN) 회귀 모델을 앙상블 형태로 구성하는 방법을 제안한다. k-NN은 입력 데이터와 가장 가까운 k개의 이웃 정보를 기반으로 출력값을 추정하는 비모수적 사례 기반 학습 알고리즘이다. 개별 k-NN 모델에 서로 다른 하이퍼파라미터 조합을 적용하면, 유사한 구조를 가지면서도 서로 다른 예측 특성을 갖는 다수의 독립적인 회귀 모델을 효율적으로 생성할 수 있다. 예를 들어 이웃 개수 k는 k = 3, 4, 5, 6, 7, 8, 9 등으로 변화시켜 모델의 편향-분산 트레이드오프를 조절할 수 있다.
아울러 거리 척도인 민코프스키 거리(Minkowski distance)의 차수 p를 1.0, 1.2, 1.4, 1.6, 1.8, 2.0 등으로 다양화하여 서로 다른 공간 근접성 기준을 적용할 수 있다(p = 2는 유클리드 거리). 이러한 조합을 통해 42개의 서로 다른 k-NN 회귀 모델로 구성된 앙상블을 구축할 수 있다. 이 앙상블을 활용하면 학습(데이터 저장) 비용이 사실상 O(1)이며, 예측 과정에서도 훈련 데이터 전체의 공분산 행렬을 다루지 않고 가장 가까운 표본들만 참조하므로 예측 평균과 분산을 O(N)의 계산 복잡도로 얻어낼 수 있다. 이는 연산량이 O(N3)인 GP 대비 비약적인 가속화이며, 다차원 공간에서의 고분해능 측정을 현실화하는 핵심 동력이 된다. 또한 고분해능 측정(N 값이 큰 경우)에서 압도적으로 유리하다. 그림 2는 다중 해상도(multi-resolution) 측정 전략과 회귀 모델 기반 보간 방법을 설명한다.

4. 지능적 가속 측정 알고리즘의 구현
구축된 다중 k-NN 앙상블 회귀 모델을 활용하면 그림 3과 같은 가속형 고해상도 측정 알고리즘을 구현할 수 있다. 먼저 성긴 격자(coarse grid)를 설정하고 해당 지점에서 초기 물리 측정(coarse sampling)을 수행한다. 수집된 초기 측정 데이터를 이용하여 앙상블을 구성하는 모든 k-NN 회귀 모델을 동시에 학습시킴으로써, 측정 대상 공간에 대한 초기 대리 모델(surrogate model)을 구축한다. 다음 단계에서는 보다 세밀한 격자(fine grid)를 대상으로 실제 측정을 수행하기에 앞서, 학습된 다중 k-NN 모델을 이용하여 각 후보 지점의 예측 평균 μ(x)와 불확실성(분산) σ(x)을 계산한다. 이 과정에서 예측값뿐만 아니라 모델의 신뢰도까지 동시에 확보할 수 있으므로, 실제 측정이 필요한 영역을 사전에 판단할 수 있다.
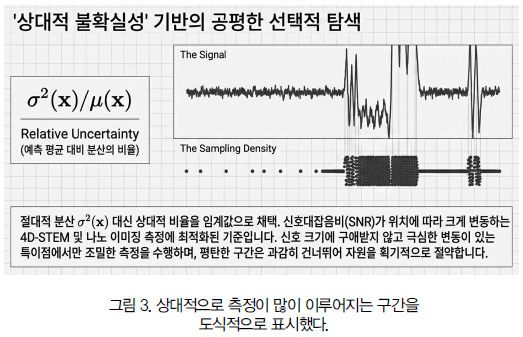
이후 능동 선택(active selection) 단계에서는 계산된 불확실성을 기준으로 실제 측정 여부를 결정한다. 예측 분산이 미리 설정한 임계값보다 작으면 해당 영역은 모델의 예측 신뢰도가 충분히 높다고 판단하여 실제 측정을 생략한다. 반대로 예측 분산이 임계값 이상이면 새로운 정밀 측정을 수행하여 모델의 예측 정확도를 보완한다. 또한 절대적인 분산 σ(x) 대신 예측 평균 μ(x) 대비 상대 분산을 판단 기준으로 사용할 수도 있다. 이러한 상대적 불확실성(relative uncertainty) 기반 접근은 위치에 따라 신호대잡음비(SNR)가 크게 달라지는 나노 이미징 및 정밀 측정 환경에서 특히 효과적이다. 신호가 강한 영역과 약한 영역 모두에서 동일한 기준으로 측정 필요성을 판단할 수 있기 때문이다.
새로운 측정 데이터가 확보되면 앙상블을 구성하는 모든 회귀 모델을 즉시 또는 일정한 배치(batch) 단위로 갱신한다. 이렇게 갱신된 모델은 다음 측정 지점의 예측 정확도를 더욱 향상시키며, 이 과정을 반복함으로써 능동학습(active learning) 기반의 순차적 측정 전략이 구현된다.
이러한 전략을 적용하면 신호 변화가 급격한 경계(edge)나 특이점(singularity) 주변에서는 자동으로 조밀한 고해상도 측정을 수행하고, 반대로 신호 변화가 거의 없는 평탄한 영역에서는 불필요한 측정을 최소화할 수 있다. 또한 필요에 따라 더 높은 해상도의 격자를 단계적으로 적용함으로써, 동일한 원리를 반복적으로 수행하는 다중 해상도(multi-resolution) 측정 전략으로 확장할 수 있다. 그림 3은 불확실성이 높은 영역에서만 선택적으로 측정이 수행되는 능동 샘플링 과정을 개념적으로 보여준다. 그림 4는 기존 래스터 스캔 방식과 제안한 능동 측정 방식의 측정 효율을 비교한 결과를 나타낸다.
5. 효율성 평가 방법
머신러닝 분야에서는 모델이 불필요한 측정을 얼마나 효과적으로 줄여 시간과 비용을 절감하는지를 표본 효율성(sample efficiency) 또는 질의 효율성(query efficiency)으로 평가한다. 본 연구에서는 이러한 효율성을 정량적으로 평가하기 위해 생략률(skip rate)을 정의하고, 핵심 성능지표로 활용하였다.
생략률은 새로운 측정 후보가 생성되었을 때, 모델이 해당 지점에 대해 실제 측정이 필요한지 여부를 판단하여 측정을 생략한 비율을 의미한다. 다차원 설계 공간에서는 임의의 새로운 측정 포인트를 언제든지 생성할 수 있으며, 모델은 각 포인트에 대해 추가 측정이 필요한지 또는 기존 학습 결과만으로 충분히 예측 가능한지를 판정한다. 추가 측정이 불필요하다고 판단된 경우 해당 측정은 생략되며, 모델의 예측값으로 대체된다. 반대로 예측 불확실성이 허용 기준을 초과하는 경우에는 실제 측정을 수행하고, 새롭게 확보된 데이터를 이용하여 모델을 다시 학습시킨다.
평가 절차는 다음과 같다. 첫 번째 학습 단계에서는 모든 측정 데이터를 모델 학습에 사용해야 하므로 생략률은 0 %이다. 이후 단계에서는 추가 측정 횟수를 일정하게 유지한 상태에서 충분한 수의 무작위 측정 후보를 생성하고, 실제 측정이 필요한 비율을 평가하여 생략률을 계산한다. 이러한 방식은 모델의 학습이 진행될수록 실제 측정을 얼마나 효과적으로 줄일 수 있는지를 정량적으로 보여준다.
능동학습(active learning)에서 생략률 95 %는 단순한 수치를 넘어 모델의 학습 수준과 실험 효율성을 동시에 나타내는 중요한 지표이다. 이는 전체 후보 지점의 대부분에 대해 실제 측정을 수행하지 않고도 모델이 충분한 신뢰도로 결과를 예측할 수 있음을 의미한다. 다시 말해, 모델이 대상 공간의 구조를 상당 수준 학습하여 대부분의 영역에서 예측 불확실성을 허용 범위 이내로 감소시켰음을 시사한다. 따라서 완만한 변화 영역뿐 아니라 변화가 큰 영역까지도 효과적으로 식별할 수 있는 수준의 학습이 이루어졌다고 해석할 수 있다.
생략률이 높아질수록 실험 시간과 비용 절감 효과도 커진다. 일반적인 전수 조사 방식에서는 모든 후보 지점에 대해 동일한 측정 비용이 발생하지만, 생략률이 95 %인 경우에는 전체 후보 지점 가운데 약 5 %만 실제로 측정하고 나머지는 모델 예측으로 대체할 수 있다. 따라서 실험 시간과 장비 사용 비용을 크게 줄일 수 있으며, 연구 수행의 효율성을 획기적으로 향상시킬 수 있다.
생략률은 실험 종료 시점을 판단하는 기준으로도 활용될 수 있다. 일정 수준 이상의 생략률이 지속적으로 유지된다면 모델이 새로운 정보를 거의 획득하지 못하는 수렴 상태에 도달한 것으로 판단할 수 있으며, 사전에 설정한 최대 반복 횟수에 도달하지 않았더라도 실험을 조기에 종료하는 근거로 사용할 수 있다.
다만 높은 생략률이 항상 우수한 모델 성능을 의미하는 것은 아니다. 허용오차가 지나치게 크게 설정된 경우에는 모델의 예측 정확도가 충분하지 않음에도 불구하고 많은 측정을 생략할 가능성이 있다. 이 경우에는 높은 생략률에도 불구하고 실제 예측 오차가 증가할 수 있다. 따라서 생략률은 평균절대오차(MAE)와 같은 예측 정확도 지표와 함께 해석되어야 하며, 두 지표가 모두 만족스러운 수준을 보일 때 비로소 모델이 성공적으로 수렴했다고 평가할 수 있다.
결론적으로 생략률은 능동학습 기반 측정 시스템에서 모델의 학습 수준과 실험 효율성을 동시에 평가할 수 있는 핵심 지표이다. 높은 생략률은 모델이 공간 구조를 충분히 학습하여 실제 측정을 크게 줄일 수 있음을 의미하지만, 그 타당성은 반드시 예측 오차에 대한 검증과 함께 확인되어야 한다.
6. 광역 최적점 탐색과 CMA-ES의 응용
다수의 k-NN 회귀 모델로 구성된 앙상블 기반 가속 측정법은 다차원 공간에서 광역 최적화(global optimization) 탐색 효율성 또한 크게 향상시킬 수 있다. 능동 측정을 통해 구축된 고밀도 surrogate model은 단순히 측정 데이터를 보간하거나 복원하는 역할을 넘어, 이후 최적화 과정에서 고비용 목적 함수 평가를 대체하는 핵심 예측 엔진으로 활용될 수 있다.
특히나 다차원 공간에서 전수 조사(exhaustive search)가 현실적으로 불가능한 경우, 베이지안 최적화뿐만 아니라 진화 연산(evolutionary computation) 기반 탐색 기법과의 결합이 효과적인 접근법이 된다. 그중 CMA-ES(Covariance Matrix Adaptation Evolution Strategy)는 목적 함수가 복잡하거나 노이즈가 존재하고, 미분 정보를 확보하기 어려운 비선형·비볼록(non-convex) 역설계 문제에서 강력한 최적화 성능을 제공하는 대표적인 진화 알고리즘이다. 메타표면 다층 구조 최적화와 같이 수많은 설계 변수가 상호작용하는 문제에서도 CMA-ES는 안정적인 탐색 성능을 보여준다.
CMA-ES는 목적 함수의 기울기 정보를 직접 사용하지 않고, 탐색 공간에서 후보 해를 생성하는 확률 분포 자체를 반복적으로 개선하는 방식으로 동작한다. 초기에는 평균 벡터 m, 공분산 행렬 C, 탐색 폭을 결정하는 스텝 사이즈 σ로 정의되는 정규분포에서 후보 해를 생성한다. 이후 각 후보 해의 목적 함수값을 평가하고, 성능이 우수한 해들을 선택하여 다음 세대의 탐색 분포를 갱신한다.
이 과정에서 본 연구에서 제안하는 다중 k-NN 기반 surrogate model을 결합하면, 실제 물리 실험이나 고비용 시뮬레이션 대신 대리 모델을 이용한 초고속 사전 평가(surrogate-assisted evaluation)가 가능해진다. 즉, CMA-ES는 대리 모델이 제공하는 예측값과 불확실성 정보를 활용하여 유망한 탐색 영역을 우선적으로 탐색하고, 필요한 경우에만 실제 목적 함수 평가를 수행함으로써 전체 최적화 비용을 크게 줄일 수 있다.
또한 CMA-ES는 선택된 우수 해들의 이동 경로를 기반으로 진화 경로(evolution path)를 학습하고, 이에 따라 공분산 행렬 C의 방향과 크기를 적응적으로 조정한다. 반복 과정에서 탐색 분포는 목적 함수의 최적 방향에 맞게 변화하며, 복잡한 탐색 공간에 존재하는 지역 최적점(local minima)을 효과적으로 회피하고, 전역 최적해(global optimum)에 접근할 수 있도록 한다.
7. 대리 모델 기반 진화 알고리즘
(surrogate-assisted evolutionary algorithm, SAEA)의 개념 및 동기
SAEA(Surrogate-Assisted Evolutionary Algorithm)는 고비용 목적 함수 최적화를 효율적으로 수행하기 위해 진화 알고리즘(evolutionary algorithm, EA)과 대리 모델(surrogate model)을 결합한 메타휴리스틱 최적화 프레임워크이다. SAEA는 수치 시뮬레이션, 물리 실험, 공정 측정과 같이, 함수 평가(function evaluation)에 높은 시간적·경제적 비용이 요구되는 문제에서 실제 평가 횟수를 줄이면서 최적화 성능을 유지하기 위해 개발되었다.
SAEA는 크게 네 가지 핵심 요소로 구성된다.
첫째, 대리 모델(surrogate model)은 실제 목적 함수의 입력–출력 관계를 근사하는 데이터 기반 모델이다. Gaussian process(GP), radial basis function (RBF), random forest, LightGBM 등의 회귀 모델이 활용되며, 고비용의 실제 목적 함수 평가를 대신하여 후보 해(candidate solution)의 성능을 빠르게 예측하는 역할을 수행한다.
둘째, 보조적 결합(assisted mechanism)은 진화 알고리즘이 독립적으로 탐색을 수행하는 것이 아니라, 대리 모델의 예측 정보를 활용하여 탐색 방향과 평가 대상을 효율적으로 결정하는 구조를 의미한다. 즉, 대리 모델은 단순한 근사기가 아니라 실제 평가 자원을 어디에 집중할 것인지 판단하는 의사결정 지원 도구로 활용된다.
셋째, 진화 기반 탐색(evolutionary search)은 개체군(population)을 기반으로 변이(mutation), 교차(crossover), 선택(selection) 연산을 반복 수행하며 전역 최적해를 탐색하는 확률적 최적화 방법이다. 대표적인 알고리즘으로는 genetic algorithm(GA), particle swarm optimization(PSO), covariance matrix adaptation evolution strategy(CMA-ES) 등이 있다.
넷째, 알고리즘(algorithm)은 위의 구성요소들을 통합하여 후보 생성, 예측 평가, 실제 검증, 모델 갱신으로 이어지는 반복적 최적화 절차를 정의한다.
전통적인 진화 알고리즘은 넓은 탐색 공간에서 강인한 전역 탐색 능력을 제공하지만, 각 세대마다 다수의 후보 해에 대해 실제 목적 함수 평가를 수행해야 한다는 한계가 있다. 특히 목적 함수가 고차원 물리 시뮬레이션이나 실제 실험 기반 시스템으로 구성되는 경우, 단 한 번의 평가에도 상당한 계산 시간과 비용이 소요된다. 예를 들어 computational fluid dynamics(CFD) 해석은 하나의 평가에 수 시간 이상이 소요될 수 있으며, 반도체 공정이나 정밀 계측 시스템 역시 개별 평가 비용이 높아 반복 최적화 적용에 제약이 따른다. 이러한 문제는 최적화 분야에서 평가 병목(evaluation bottleneck)으로 정의된다.
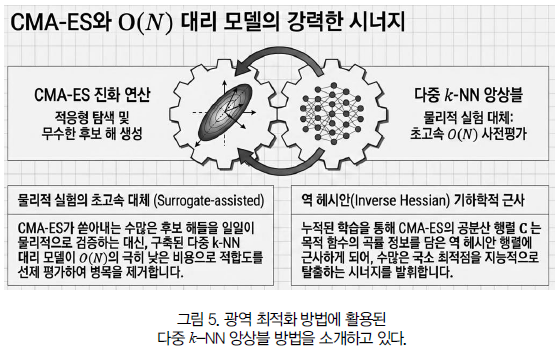
SAEA는 이러한 평가 병목을 완화하기 위해 실제 목적 함수 평가와 대리 모델 예측을 결합한 이중 평가 구조를 사용한다. 먼저 진화 알고리즘은 기존 방식과 같이 후보 해 집단을 생성하지만, 모든 후보에 대해 즉시 실제 평가를 수행하지 않는다. 대신 대리 모델을 이용해 후보 해의 목적 함수값을 우선 예측하고, 예측 결과와 불확실성 정보를 기반으로 실제 평가가 필요한 후보를 선별한다.
이 과정에서 대리 모델은 두 가지 역할을 수행한다. 첫째, 기존 평가 데이터를 기반으로 후보 해의 성능을 빠르게 추정한다. 둘째, 예측 오차가 크거나 불확실성이 높은 영역을 식별하여 탐색 다양성을 유지한다. 이후 높은 성능이 예상되거나 추가 정보 획득 가치가 높은 후보만 실제 목적 함수 평가를 수행하며, 획득된 데이터는 다시 대리 모델 학습에 활용되어 예측 정확도를 지속적으로 향상시킨다.
이러한 반복 과정은 순차적 모델 관리(sequential model management) 또는 적응형 샘플링(adaptive sampling) 구조로 해석할 수 있다. 즉, SAEA는 전체 탐색 공간에서 필요한 실제 평가 횟수를 최소화하면서도, 대리 모델을 활용한 효율적인 탐색을 통해 최적해에 접근하는 하이브리드 최적화 프레임워크이다.
본 연구에서는 이러한 SAEA 구조에 다중 k-NN 회귀 모델 앙상블을 적용하여 고속 대리 모델을 구성하고, 이를 광역 최적화 과정에 활용한다. 그림 5는 다중 회귀 모델 기반 대리 모델과 광역 최적화 알고리즘이 결합된 구조 및 그 시너지 효과를 개념적으로 설명한다.
8. 결 론
나이퀴스트-섀넌 샘플링 정리에 기반한 획일적 래스터 스캔 방식은 다차원 정밀 측정 환경에서 측정 시간과 데이터 처리 비용 증가라는 근본적인 한계에 직면하고 있다. 이에 비해 다양한 k와 p 파라미터 조합으로 구성된 k-NN 모델 앙상블은 기존 가우시안 프로세스(GP) 기반 베이지안 모델의 O(N3) 반복 업데이트 부담을 줄이고, 데이터 기반 불확실성(분산) 추정을 통해 효율적인 탐색과 측정 위치 선정을 가능하게 한다.
또한 고속 대리 모델(surrogate model)을 기반으로 지능형 능동 샘플링(active sampling)과 CMA-ES (Covariance Matrix Adaptation Evolution Strategy)와 같은 진화 연산 알고리즘을 결합하면, 4D-STEM 데이터 처리와 양자 제어 등 높은 계산 비용과 정밀한 탐색이 요구되는 분야에서 측정 자원을 효율적으로 배분할 수 있다. 이를 통해 불필요한 측정을 최소화하면서도 고분해능 이미징과 정밀 측정을 획기적으로 가속화할 수 있을 것으로 기대된다.
ihlee@kriss.re.kr


